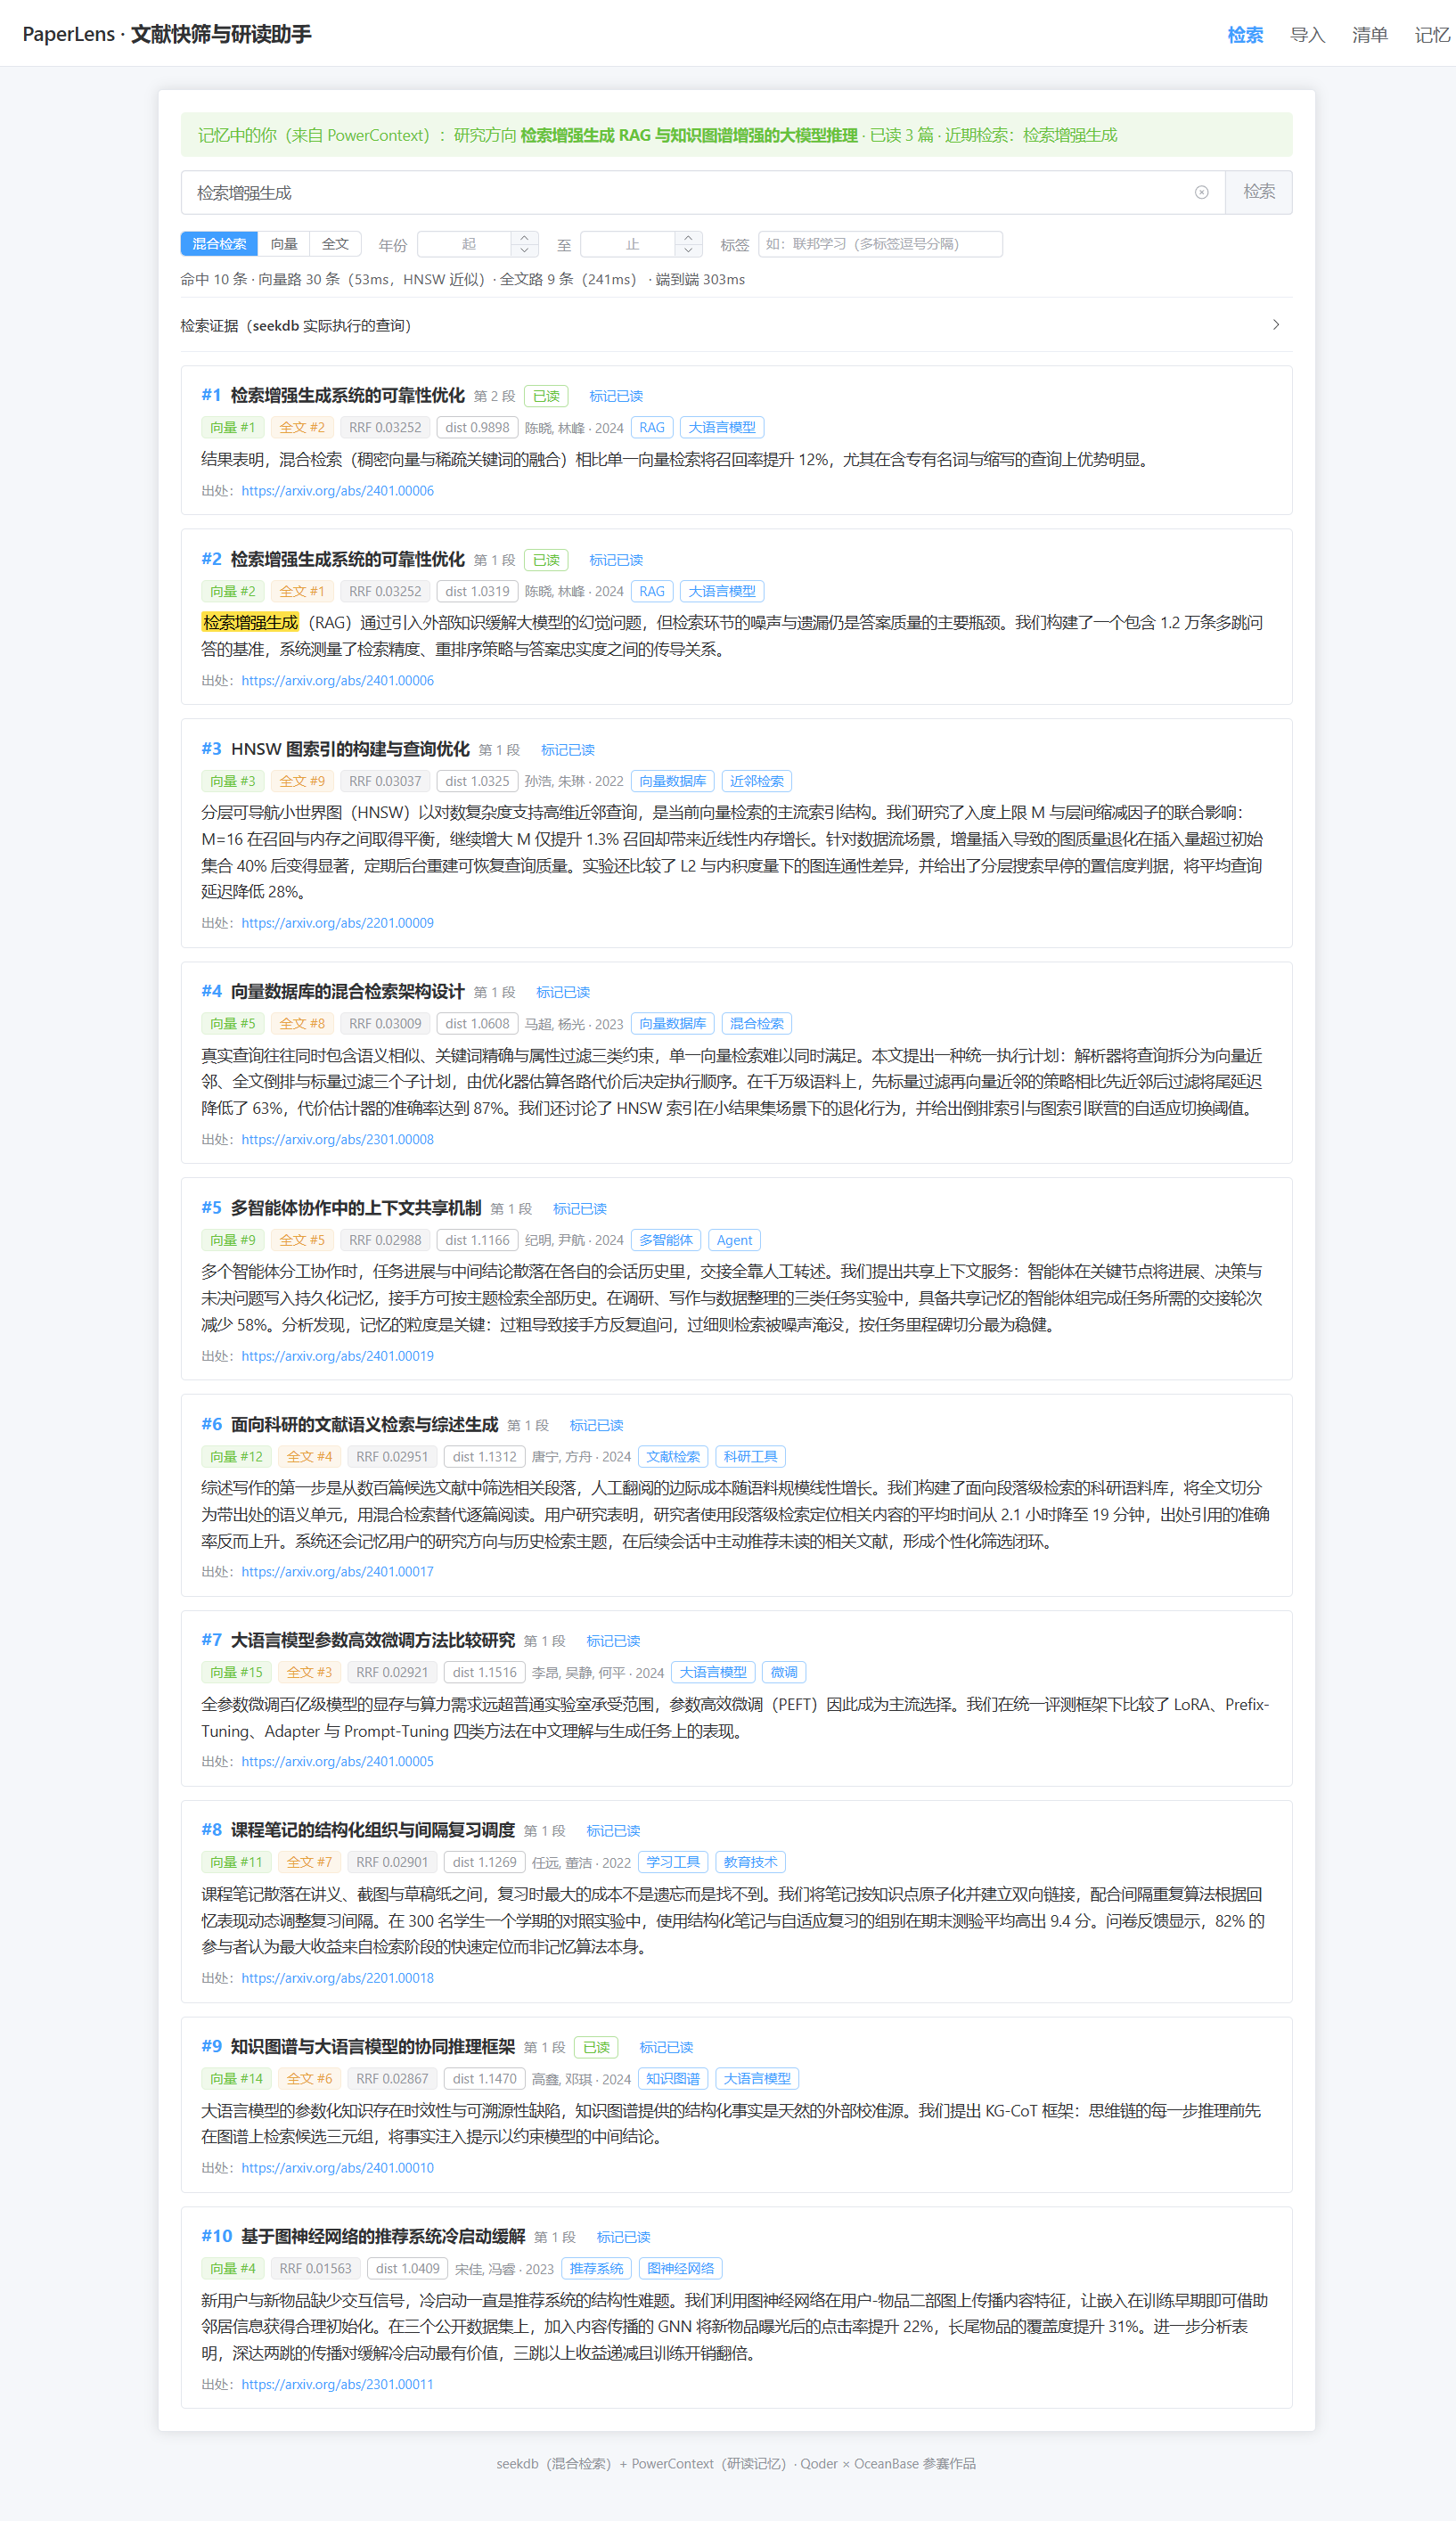
把「翻几十篇论文找相关段落」变成一次混合检索;
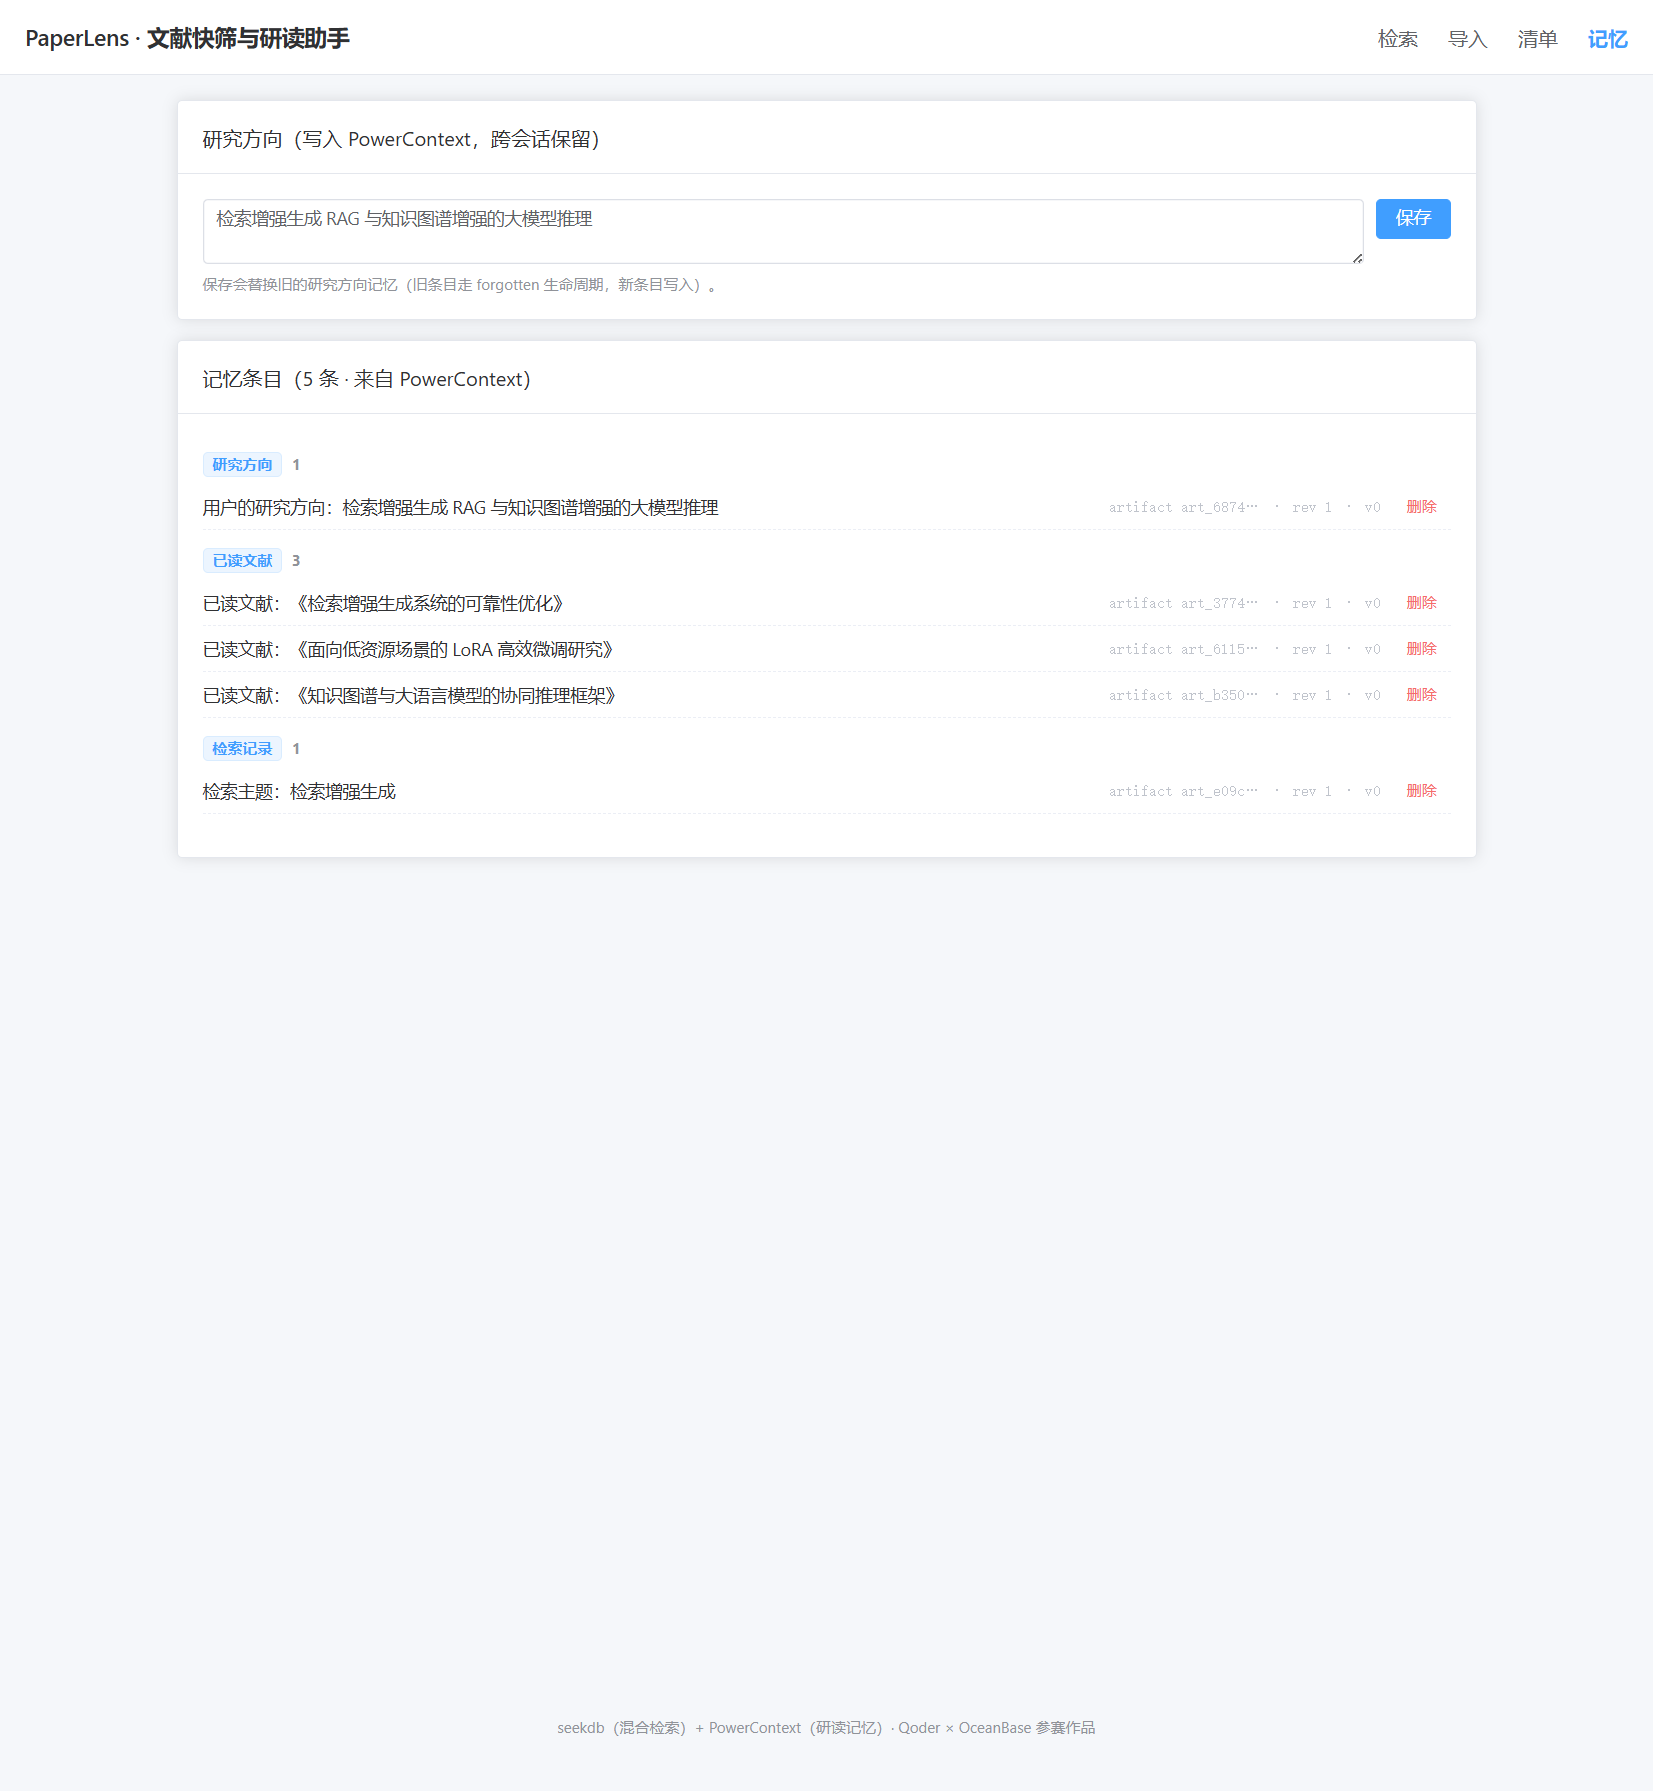
把「读过就忘」交给 PowerContext 研读记忆 —— 越用越懂你的文献工作台。
完整应用已部署在公网服务器:seekdb 混合检索 + PowerContext 记忆,浏览器打开即用
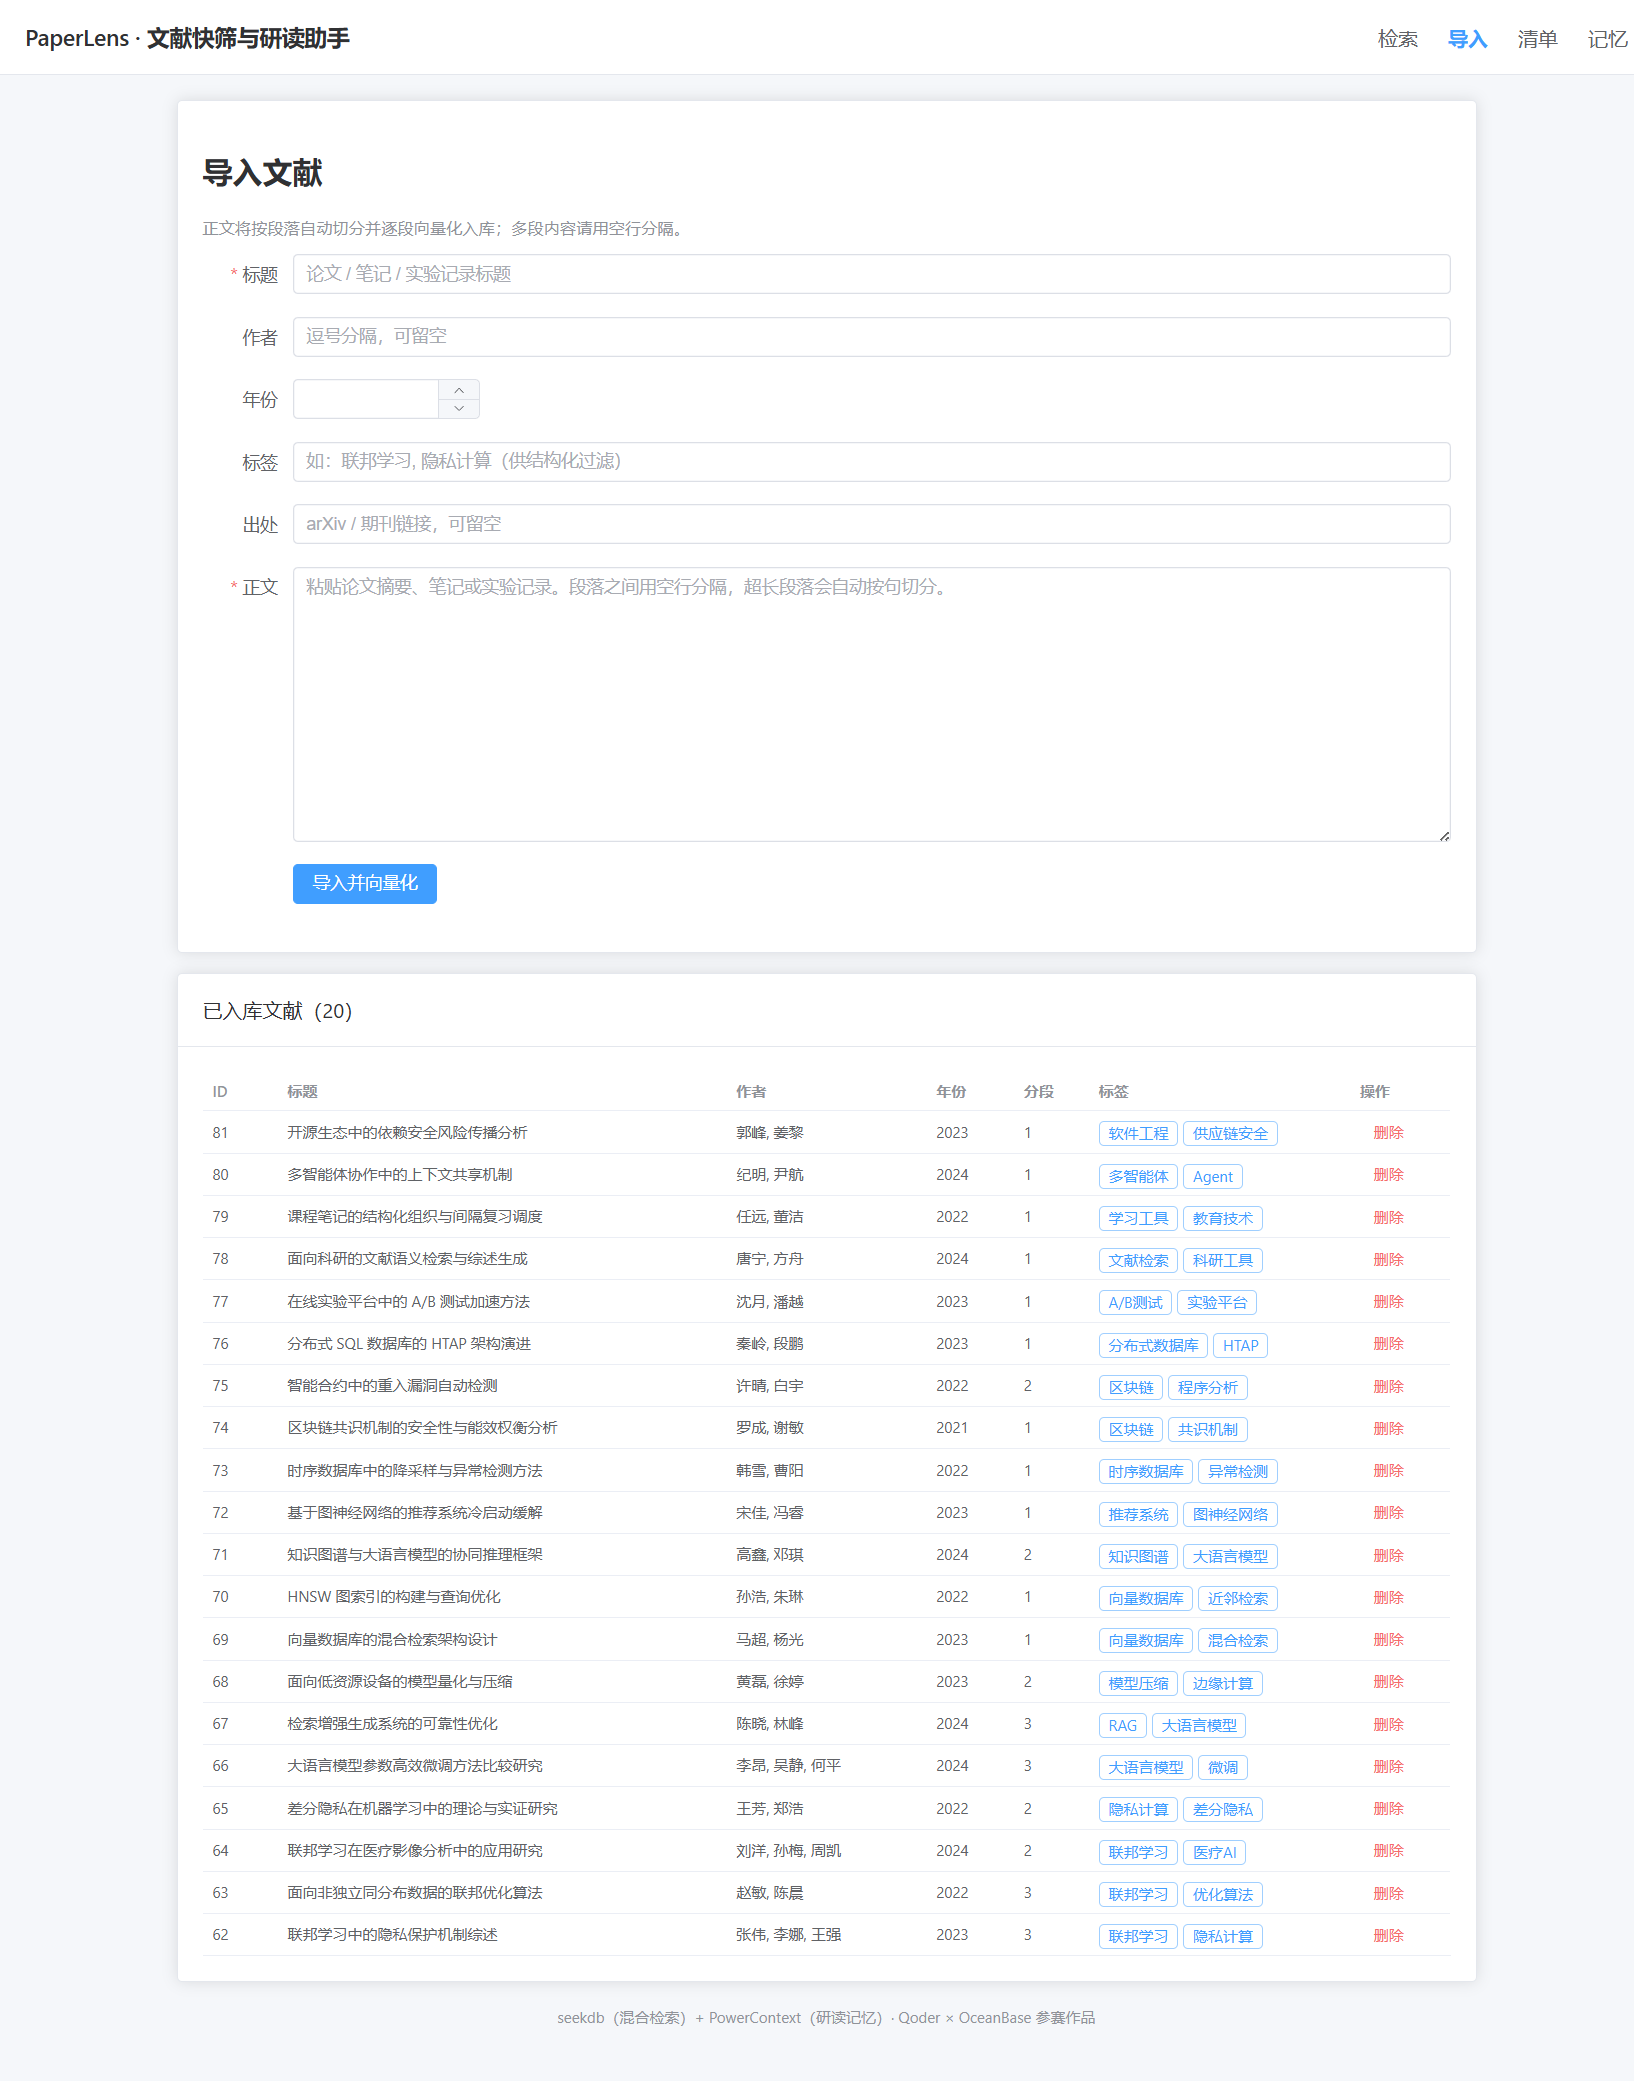
已预置 20 篇示例文献 / 33 个段落,无需注册与 API Key。检索、导入、标记已读、导出综述初稿均可真实操作,
数据写入服务器端 seekdb 与 PowerContext。
演示环境为 HTTP 明文访问,请勿在其中填写真实个人信息。
科研与学习中最耗时的不是读文献,而是「找」与「记」
写综述的第一步是逐篇翻阅候选论文,找到相关段落全靠肉眼比对,时间随语料规模线性增长。
纯关键词检索漏掉换说法的同义内容,纯向量检索又拿不准专有名词与缩写,两路结果还各有排序。
上次筛过哪些文献、标记过哪些已读、我的研究主线是什么——换个会话、换台机器就断了。
四个页面覆盖「导入 → 检索 → 研读 → 沉淀」完整闭环
用一句自然语言描述要找的内容,seekdb 双路检索并发执行、RRF 融合,结果按段落返回并高亮。
粘贴文献全文与元信息,导入管线自动完成分段、向量化与入库,导入后立即可检索。
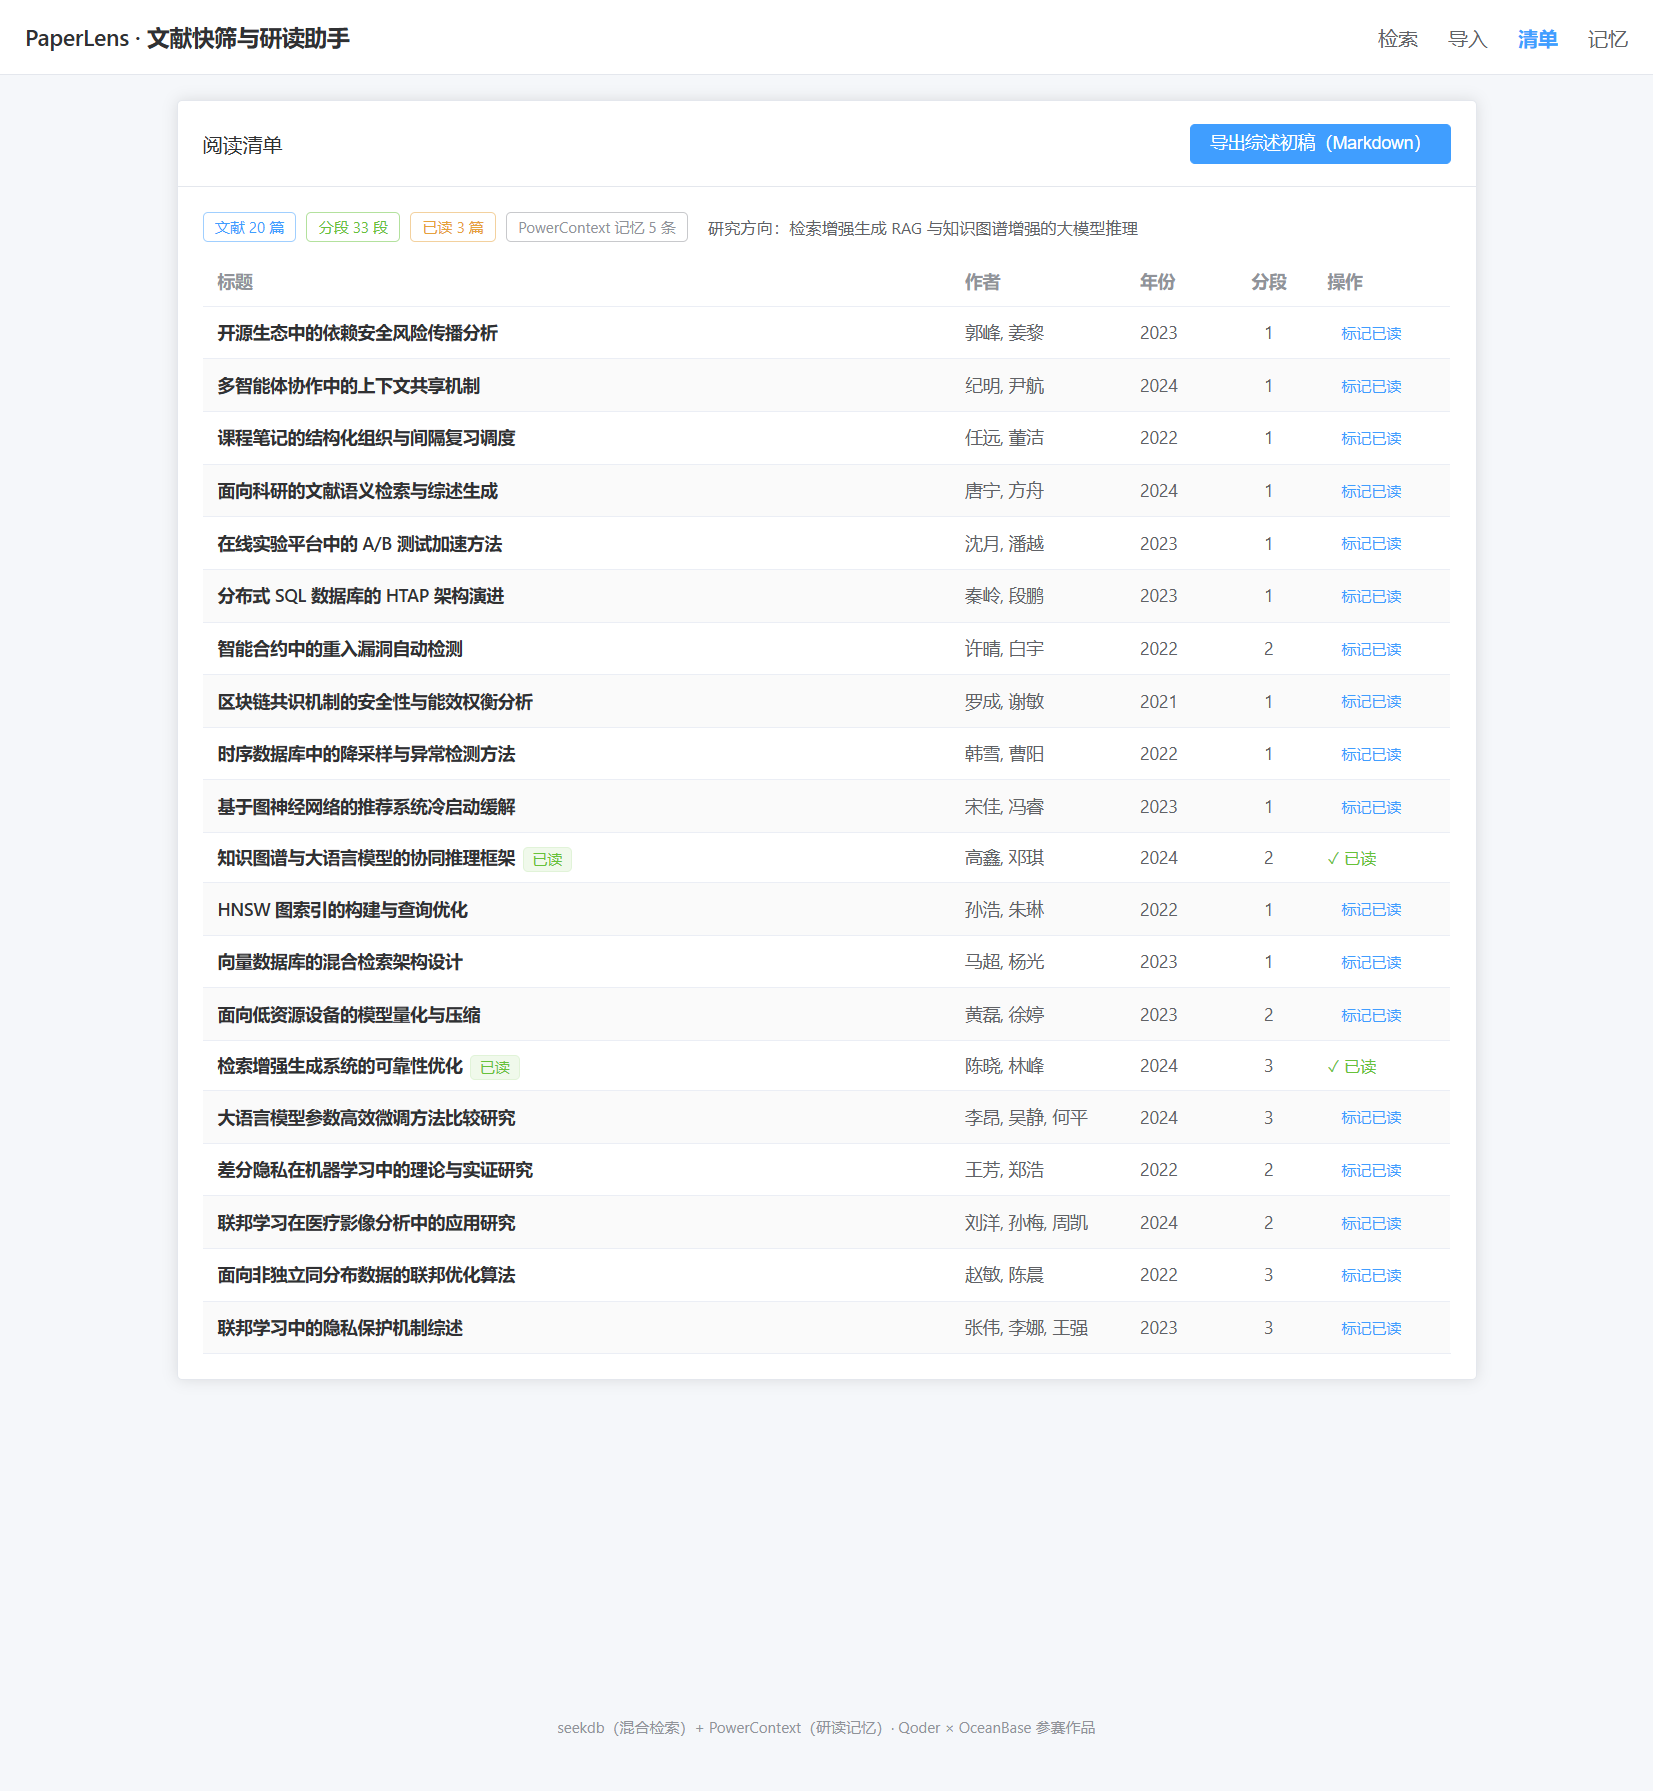
清单页聚合 seekdb 文档库与 PowerContext 已读记忆,一键导出结构化 Markdown 综述初稿。
研究方向、已读文献、检索主题全部持久化在 PowerContext,重启服务、更换会话记忆不丢。
seekdb 负责「找得快、找得准」,PowerContext 负责「记得住、跨会话」
VECTOR INDEX (TYPE=hnsw, LIB=vsag) + ORDER BY l2_distance(...) APPROXIMATE,小语料自动回退精确扫描FULLTEXT ... WITH PARSER ik 中文分词 MATCH…AGAINST以下数据来自开发过程中的真实运行记录(示例语料:20 篇文献 / 33 段落)
验证样例:POST /api/search {"query":"LoRA 微调"} → LoRA 论文同时命中向量路 #1 与全文路;导出综述初稿后可在 Markdown 中核对 seekdb 推荐与 PowerContext 已读来源。
完整验证步骤见仓库 qoder/paperlens/CONFIG.md 与 docs/ 目录。
在线版公网实测(http://47.108.177.34):查询「LoRA 如何降低大模型微调成本」→ 命中 10 条,向量路 30 条(10ms,HNSW 近似)、全文路 21 条(288ms),端到端 385ms;标记已读即时写入 PowerContext 并在顶栏提示中回显。
零 API Key:本地 embedding 模型 + 免模型 PowerContext + seekdb 连接配置
uv;克隆 https://github.com/leeplace0928/powercontext-2026.git 并切换到 2026-competition-ecosystem 分支,项目位于 qoder/paperlens/uv tool install --force "powercontext[cli,server]==1.4.1",用免模型模板生成 .env 后启动 powercontext server run --env-file .envconfig.example.json 为 config.local.json,填入你的 seekdb 地址与账号(文件已 gitignore)node scripts/download-model.mjs 下载本地 embedding 模型(hf-mirror,约 118MB;已预下载到 backend/models/ 可跳过)npm install,然后 npm run dev 同时启动后端(:3001)与前端(:5173)node scripts/seed.mjs 灌入 20 篇示例文献;浏览器打开 http://localhost:5173 体验完整流程不想本地部署?直接访问在线版 http://47.108.177.34/search(同一套代码,已预置示例语料)。
在线版已部署在公网,打开即用;也可按上方六步在本地跑通全部功能。
本项目由 Qoder 完成需求拆解、编码、调试与验证全程开发。